Domain derbeistand.de kaufen?
Wir ziehen mit dem Projekt
derbeistand.de um.
Sind Sie am Kauf der Domain
derbeistand.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain derbeistand.de kaufen?
Wie können Informationen effizient aus unstrukturierten Datenquellen extrahiert werden?
Durch den Einsatz von Text Mining und Natural Language Processing Technologien können unstrukturierte Daten analysiert und strukturiert werden. Algorithmen wie Machine Learning können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen. Zudem können spezielle Tools und Softwarelösungen wie Data Mining Software oder Business Intelligence Plattformen eingesetzt werden, um die Extraktion von Informationen zu automatisieren und zu optimieren. **
Was sind mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen?
Mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen können unterschiedliche Datenformate, fehlerhafte Datenübertragung oder -verarbeitung sowie Inkonsistenzen in den Datenquellen selbst sein. Diese Inkongruenzen können auch durch menschliche Fehler, veraltete Daten oder unvollständige Datensätze verursacht werden. Um Inkongruenzen zu vermeiden, ist es wichtig, Datenquellen regelmäßig zu überprüfen, Datenstandards zu definieren und Datenintegrationstechnologien zu verwenden. **


Ähnliche Suchbegriffe für Datenquellen
Top-Angebote
Produkte zum Begriff Datenquellen:
-
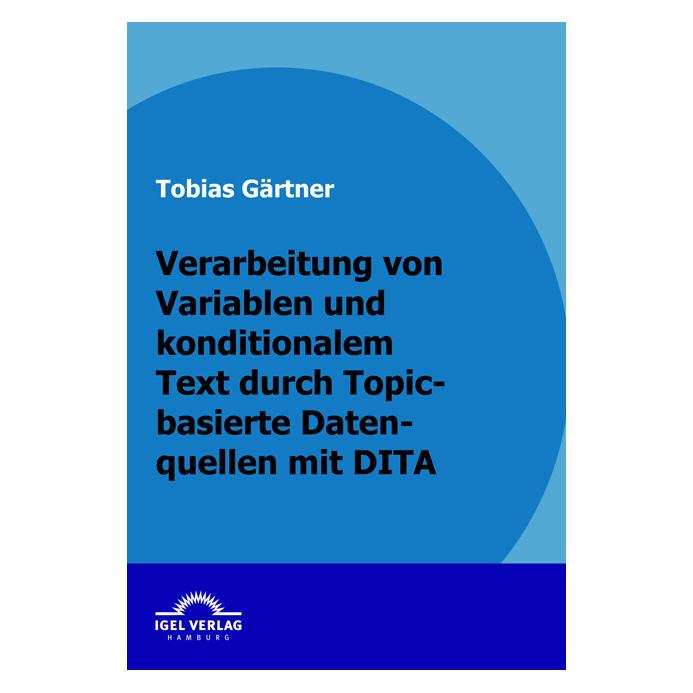
Igel Records Verarbeitung von Variablen und konditionalen Text durch Topic-basierte Datenquellen mit DITA (Deutsch, Softcover, Tobias Gärtner) (8290455)Igel Records Verarbeitung von Variablen und konditionalen Text durch Topic-basierte Datenquellen mit DITA (Deutsch, Softcover, Tobias Gärtner) (8290455)39,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Strobl, Natascha: SolidaritätSolidarität , Wir haben nur uns. Solidarität ist die Einsicht, dass die Ausgebeuteten, die Verdammten dieser Erde nur eine einzige Möglichkeit haben, ihre Rechte durchzusetzen: indem sie Mehrheiten bilden. Unsere alten Gewissheiten zerbrechen aktuell an vielgestaltigen Krisen. Dem beizukommen wäre vornehmste Aufgabe der Politik. Doch die stellt sich kein gutes Zeugnis aus: Die einen klammern sich an den Glauben, dass die verlorene Normalität rückholbar ist. Die anderen wollen die Krisen mit Individualismus oder autoritären Maßnahmen meistern - und bedrohen damit den Rechtsstaat. Natascha Strobl plädiert für einen dritten Weg: eine gemeinsame, antikapitalistische Klammer. Denn die Art, wie wir leben, produzieren und wirtschaften, muss sich grundsätzlich ändern. Das muss nichts Schlechtes bedeuten, wenn die Lösung echte Solidarität ist - ein kollektiver Wert, der individuelle Befindlichkeiten überwindet. , Lager, Buchsen & Dichtungen > Radaufhängung, Federung & Lenkung , Erscheinungsjahr: 20230310, Produktform: Leinen, Titel der Reihe: übermorgen##, Autoren: Strobl, Natascha, Seitenzahl/Blattzahl: 103, Keyword: Aktivismus; Diskutieren; Gesellschaft; Menschenrechte; Politik; Wirtschaft; Zusammenhalt, Fachschema: Solidarität, Warengruppe: HC/Politikwissenschaft/Soziologie/Populäre Darst., Fachkategorie: Soziale und ethische Themen, Text Sprache: ger, Originalsprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Kremayr und Scheriau, Verlag: Kremayr und Scheriau, Verlag: Kremayr & Scheriau GmbH & Co. KG, Verlag, Länge: 193, Breite: 126, Höhe: 16, Gewicht: 208, Produktform: Gebunden, Genre: Sozialwissenschaften/Recht/Wirtschaft, Genre: Sozialwissenschaften/Recht/Wirtschaft, Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0016, Tendenz: +1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, WolkenId: 74710220,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Verarbeitung von Variablen und konditionalen Text durch Topic-basierte Datenquellen mit DITA, Taschenbuch von Tobias Gärtner, Igel Verlag Literatur &Verarbeitung Von Variablen Und Konditionalen Text Durch Topic-basierte Datenquellen Mit Dita, Taschenbuch Von Tobias Gärtner, Igel Verlag Literatur & Wissenschaft, 978-3-86815-235-7, Seitenanzahl: 7639,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Eine Studie zu Microarray-Datenquellen und deren Verwaltung, Taschenbuch von Chirag Patel,Himanshu Pandya,Devarshi Mehta, Verlag Unser WissenEine Studie Zu Microarray-datenquellen Und Deren Verwaltung, Taschenbuch Von Chirag Patel,himanshu Pandya,devarshi Mehta, Verlag Unser Wissen, Seitenanzahl: 9666,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Welche Datenquellen werden zur Bereitstellung von aktuellen Straßeninformationen genutzt?
Zur Bereitstellung von aktuellen Straßeninformationen werden Datenquellen wie GPS-Daten von Fahrzeugen, Verkehrsüberwachungskameras und Sensoren an Straßeninfrastruktur genutzt. Zudem werden auch Daten von Verkehrsinformationsdiensten, Navigationssystemen und Mobilfunkanbietern herangezogen. Die Kombination dieser verschiedenen Datenquellen ermöglicht eine umfassende und aktuelle Darstellung des Straßenzustands. **
-
Wie werden Einkommensstatistiken erstellt und welche Datenquellen werden dafür verwendet?
Einkommensstatistiken werden in der Regel von staatlichen Behörden oder Statistikämtern erstellt. Zur Datenerhebung werden verschiedene Quellen genutzt, wie z.B. Steuererklärungen, Sozialversicherungsdaten, Umfragen oder administrative Daten von Unternehmen. Die gesammelten Daten werden analysiert und aufbereitet, um Informationen über Einkommen und Einkommensverteilung in der Bevölkerung zu liefern. **
-
Was sind die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen?
Die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen sind Inkonsistenzen in der Datenerfassung, unterschiedliche Datenformate und -strukturen sowie menschliche Fehler bei der Datenübertragung. Diese Diskrepanzen können zu falschen Analysen und Entscheidungen führen. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **

Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
Top-Angebote
Produkte zum Begriff Datenquellen:
-
Herausforderung im effizienten Umgang mit Daten unter Berücksichtigung von unterschiedlichen Datenquellen, Taschenbuch von Hans Schätzle, GRIN,Herausforderung Im Effizienten Umgang Mit Daten Unter Berücksichtigung Von Unterschiedlichen Datenquellen, Taschenbuch Von Hans Schätzle, Grin, 978-3-346-59698-7, Seitenanzahl: 3617,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Igel Records Verarbeitung von Variablen und konditionalen Text durch Topic-basierte Datenquellen mit DITA (Deutsch, Softcover, Tobias Gärtner) (8290455)Igel Records Verarbeitung von Variablen und konditionalen Text durch Topic-basierte Datenquellen mit DITA (Deutsch, Softcover, Tobias Gärtner) (8290455)39,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Strobl, Natascha: SolidaritätSolidarität , Wir haben nur uns. Solidarität ist die Einsicht, dass die Ausgebeuteten, die Verdammten dieser Erde nur eine einzige Möglichkeit haben, ihre Rechte durchzusetzen: indem sie Mehrheiten bilden. Unsere alten Gewissheiten zerbrechen aktuell an vielgestaltigen Krisen. Dem beizukommen wäre vornehmste Aufgabe der Politik. Doch die stellt sich kein gutes Zeugnis aus: Die einen klammern sich an den Glauben, dass die verlorene Normalität rückholbar ist. Die anderen wollen die Krisen mit Individualismus oder autoritären Maßnahmen meistern - und bedrohen damit den Rechtsstaat. Natascha Strobl plädiert für einen dritten Weg: eine gemeinsame, antikapitalistische Klammer. Denn die Art, wie wir leben, produzieren und wirtschaften, muss sich grundsätzlich ändern. Das muss nichts Schlechtes bedeuten, wenn die Lösung echte Solidarität ist - ein kollektiver Wert, der individuelle Befindlichkeiten überwindet. , Lager, Buchsen & Dichtungen > Radaufhängung, Federung & Lenkung , Erscheinungsjahr: 20230310, Produktform: Leinen, Titel der Reihe: übermorgen##, Autoren: Strobl, Natascha, Seitenzahl/Blattzahl: 103, Keyword: Aktivismus; Diskutieren; Gesellschaft; Menschenrechte; Politik; Wirtschaft; Zusammenhalt, Fachschema: Solidarität, Warengruppe: HC/Politikwissenschaft/Soziologie/Populäre Darst., Fachkategorie: Soziale und ethische Themen, Text Sprache: ger, Originalsprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Kremayr und Scheriau, Verlag: Kremayr und Scheriau, Verlag: Kremayr & Scheriau GmbH & Co. KG, Verlag, Länge: 193, Breite: 126, Höhe: 16, Gewicht: 208, Produktform: Gebunden, Genre: Sozialwissenschaften/Recht/Wirtschaft, Genre: Sozialwissenschaften/Recht/Wirtschaft, Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0016, Tendenz: +1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, WolkenId: 74710220,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie können Informationen effizient aus unstrukturierten Datenquellen extrahiert werden?
Durch den Einsatz von Text Mining und Natural Language Processing Technologien können unstrukturierte Daten analysiert und strukturiert werden. Algorithmen wie Machine Learning können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen. Zudem können spezielle Tools und Softwarelösungen wie Data Mining Software oder Business Intelligence Plattformen eingesetzt werden, um die Extraktion von Informationen zu automatisieren und zu optimieren. **
-
Was sind mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen?
Mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen können unterschiedliche Datenformate, fehlerhafte Datenübertragung oder -verarbeitung sowie Inkonsistenzen in den Datenquellen selbst sein. Diese Inkongruenzen können auch durch menschliche Fehler, veraltete Daten oder unvollständige Datensätze verursacht werden. Um Inkongruenzen zu vermeiden, ist es wichtig, Datenquellen regelmäßig zu überprüfen, Datenstandards zu definieren und Datenintegrationstechnologien zu verwenden. **
-
Welche Datenquellen werden zur Bereitstellung von aktuellen Straßeninformationen genutzt?
Zur Bereitstellung von aktuellen Straßeninformationen werden Datenquellen wie GPS-Daten von Fahrzeugen, Verkehrsüberwachungskameras und Sensoren an Straßeninfrastruktur genutzt. Zudem werden auch Daten von Verkehrsinformationsdiensten, Navigationssystemen und Mobilfunkanbietern herangezogen. Die Kombination dieser verschiedenen Datenquellen ermöglicht eine umfassende und aktuelle Darstellung des Straßenzustands. **
-
Wie werden Einkommensstatistiken erstellt und welche Datenquellen werden dafür verwendet?
Einkommensstatistiken werden in der Regel von staatlichen Behörden oder Statistikämtern erstellt. Zur Datenerhebung werden verschiedene Quellen genutzt, wie z.B. Steuererklärungen, Sozialversicherungsdaten, Umfragen oder administrative Daten von Unternehmen. Die gesammelten Daten werden analysiert und aufbereitet, um Informationen über Einkommen und Einkommensverteilung in der Bevölkerung zu liefern. **
Ähnliche Suchbegriffe für Datenquellen
-
Verarbeitung von Variablen und konditionalen Text durch Topic-basierte Datenquellen mit DITA, Taschenbuch von Tobias Gärtner, Igel Verlag Literatur &Verarbeitung Von Variablen Und Konditionalen Text Durch Topic-basierte Datenquellen Mit Dita, Taschenbuch Von Tobias Gärtner, Igel Verlag Literatur & Wissenschaft, 978-3-86815-235-7, Seitenanzahl: 7639,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Eine Studie zu Microarray-Datenquellen und deren Verwaltung, Taschenbuch von Chirag Patel,Himanshu Pandya,Devarshi Mehta, Verlag Unser WissenEine Studie Zu Microarray-datenquellen Und Deren Verwaltung, Taschenbuch Von Chirag Patel,himanshu Pandya,devarshi Mehta, Verlag Unser Wissen, Seitenanzahl: 9666,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Engel - Himmlischer Beistand für alle TageEngel Enthält 24 Geflügelte Botschaften, Die Von Der Fürsorge Und Liebevollen Zuwendung Gottes Zu Uns Menschen Hin Zeugen. Ob Schutzengel, Engel Der Freundschaft, Trostengel Oder Friedensengel – Die Biblischen Und Populären Engelsbotschaften Sind...7,00 €*Versand: 2,95 €Sichere Weiterleitung zum Anbieter
-
Der Schutz von Haushalt und Solidarität in der EU, Fachbücher von Ann-Kathrin Viktoria BrämerDas Fachbuch "Der Schutz von Haushalt und Solidarität in der EU" von Ann-Kathrin Viktoria Brämer bietet eine umfassende Analyse der Beziehung zwischen dem EU-Haushalt und dem Prinzip der Solidarität, das als grundlegendes verfassungsrechtliches Prinzip der Europäischen Union gilt. Die Autorin untersucht, wie der Haushalt als zentrales Ausdrucksmittel dieses Prinzips fungiert und beleuchtet bestehende Schutzmechanismen hinsichtlich ihrer Stärken und Schwächen. Ein besonderer Fokus liegt auf der Conditionality Regulation (Verordnung (EU) 2020/2092), einem innovativen Instrument zur Sicherstellung von Solidarität, für das konkrete Reformvorschläge entwickelt und bewertet werden. Dieses Buch richtet sich an Fachleute und Interessierte, die ein tieferes Verständnis für die finanziellen und solidarischen Strukturen der EU erlangen möchten.89,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen?
Die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen sind Inkonsistenzen in der Datenerfassung, unterschiedliche Datenformate und -strukturen sowie menschliche Fehler bei der Datenübertragung. Diese Diskrepanzen können zu falschen Analysen und Entscheidungen führen. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.